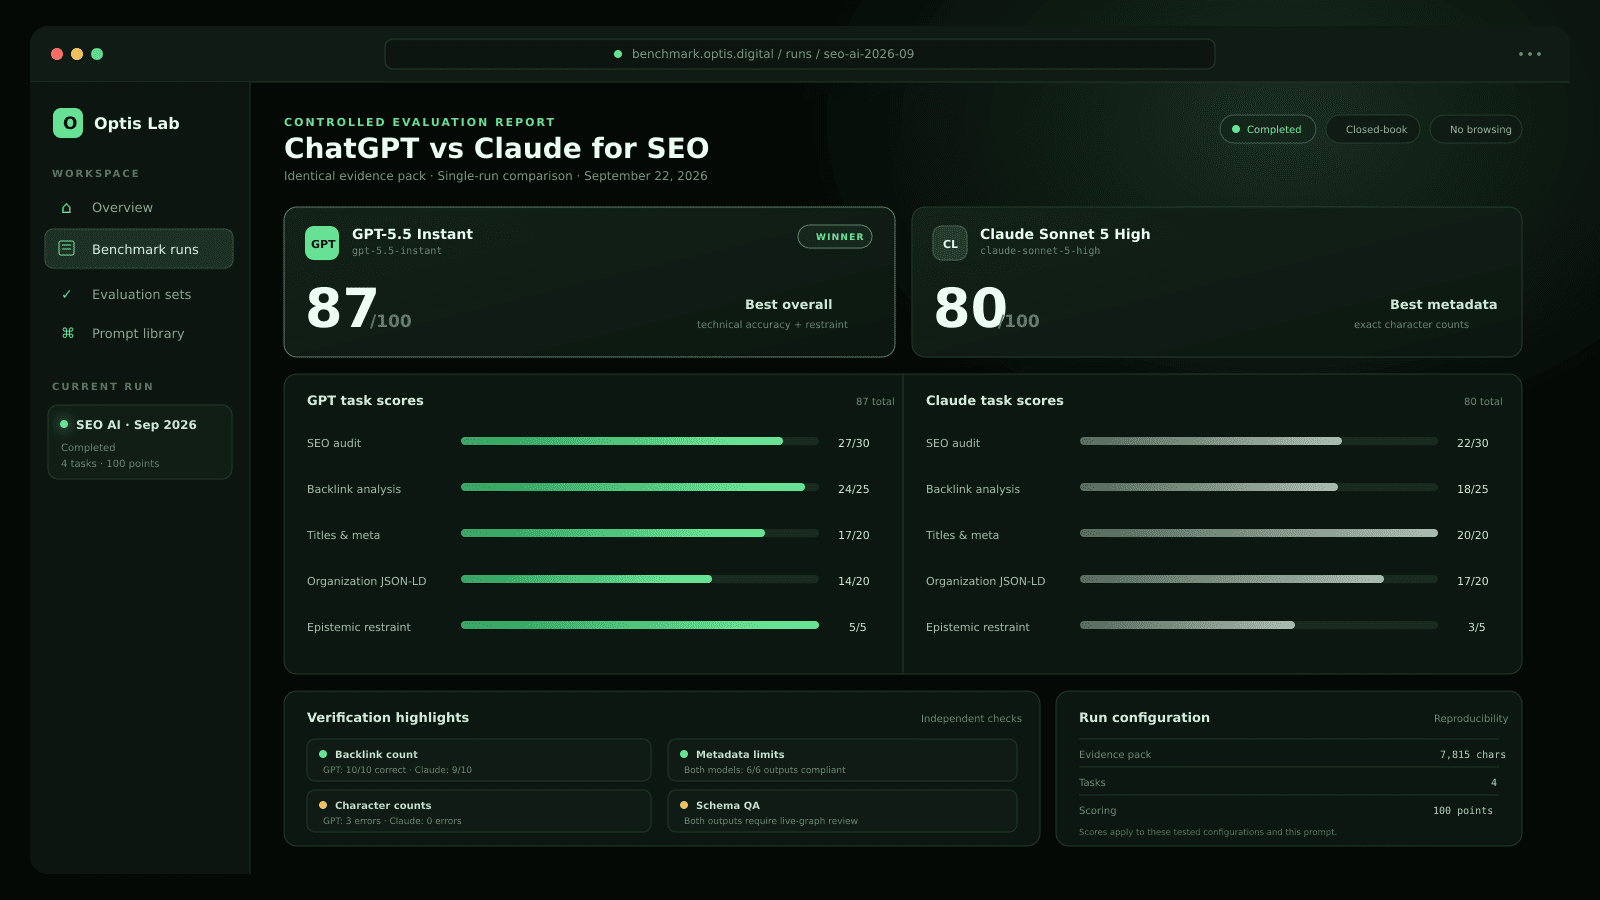
Welche KI eignet sich 2026 besser für SEO-Arbeit? Ich gab GPT und Claude dasselbe Closed-Book-Briefing: einen Homepage-Snapshot prüfen, einen Backlink-Export mit 18 Zeilen analysieren, Meta-Tags unter klaren Vorgaben schreiben und verknüpftes Organization JSON-LD erstellen. GPT gewann den gemischten technischen Workflow, während Claude bei Metadaten besser und bei Entity-Markup leicht überlegen war.
Zunächst eine wichtige Klarstellung zu den Modellen
„ChatGPT versus Claude“ ist eine Frage auf Produktebene, aber Modelle verändern sich schneller als die meisten Vergleichsartikel. Am 22. September 2026 beschreibt OpenAI GPT-6 Astra als sein leistungsfähigstes Modell für anspruchsvolle End-to-End-Aufgaben. Es besitzt ein Kontextfenster von 1,05 Millionen Tokens, eine maximale Ausgabelänge von 128.000 Tokens sowie API-Preise von 10 US-Dollar pro Million Input-Tokens und 50 US-Dollar pro Million Output-Tokens. OpenAI positioniert außerdem GPT-5.6 Sol als professionelles Flaggschiffmodell zu 4/20 US-Dollar pro Million Input-/Output-Tokens.
Anthropics aktuelles Modellportfolio sieht anders aus. Der offizielle Modellvergleich führt Claude Fable 5.1 für anspruchsvolles Reasoning und langfristige Aufgaben, Claude Opus 5 für komplexe Enterprise-Anwendungen und Claude Sonnet 5 für Geschwindigkeit und Intelligenz im großen Maßstab auf. Fable 5.1, Opus 5 und Sonnet 5 unterstützen jeweils ein Kontextfenster von einer Million Tokens sowie bis zu 128.000 Output-Tokens. Anthropic empfiehlt Opus 5 als Ausgangspunkt für die meisten Workloads und Fable 5.1, wenn selbst Opus-Evaluierungen mit höherem Reasoning-Aufwand nicht ausreichen.
Der folgende kontrollierte Test verglich nicht GPT-6 Astra mit Claude Fable 5.1. Diese beiden Modelle waren in der für das Experiment genutzten unabhängigen Oberfläche nicht gleichzeitig verfügbar. Tatsächlich verglichen wurden gpt-5.5-instant und claude-sonnet-5-high, Seite an Seite getestet auf Arena. Die Methodik der paarweisen Evaluierung von Arena wird im Chatbot-Arena-Paper der Forscher beschrieben. Diese Unterscheidung ist wichtig: Die Ergebnisse beziehen sich auf die getesteten Modellkonfigurationen und nicht auf jedes Modell oder jede Funktion innerhalb der Anwendungen ChatGPT und Claude.
Wie ich das SEO-Experiment aufgebaut habe
Beide Modelle erhielten in einer neuen Side-by-Side-Session denselben Prompt mit 7.815 Zeichen. Browsing war untersagt. Das Briefing wies jedes Modell an, ausschließlich die bereitgestellten Daten zu verwenden, Beobachtungen von Empfehlungen zu trennen, keine Messwerte zu erfinden und klar anzugeben, was weiterhin durch einen Menschen oder First-Party-Tools überprüft werden musste.
Der Benchmark umfasste vier praktische SEO-Aufgaben:
SEO-Audit: zehn Ergebnisse aus einem Homepage-Snapshot priorisieren, der Status, Indexierbarkeit, Canonical, Überschriften, Sprachanmerkungen, Alt-Text-Abdeckung von Bildern, sichtbaren Text, Structured-Data-Fakten und ein kontrolliertes Core-Web-Vitals-Datenset enthielt.
Backlink-Analyse: Summen aus einem Export mit 18 Zeilen berechnen, Konzentrations- und Anchor-Risiken identifizieren, verlorene oder fehlerhafte Chancen erkennen und fünf Maßnahmen empfehlen, ohne reflexartig ein Disavow zu empfehlen.
Metadaten: drei unterschiedliche Title-/Description-Paare für das exakte Keyword „ChatGPT vs Claude für SEO“ erstellen, Titles auf maximal 60 Zeichen begrenzen, Beschreibungen zwischen 145 und 160 Zeichen halten und für jedes Element die Zeichenzahl angeben.
Organization-Schema: eine verknüpfte Person-Entity zu einer bestehenden Organization hinzufügen, ohne eine zweite Organisation zu erstellen oder Bewertungen, Qualifikationen, eine Straßenadresse oder Telefonnummer zu erfinden.
Die Struktur der Homepage basierte auf einer Live-Prüfung von Optis Digital am Testtag. Aus Datenschutzgründen und zur experimentellen Kontrolle waren die Backlink-Zeilen, Felddaten zur Performance, Kontaktdaten und die Gründeridentität innerhalb des Prompts synthetische Testdaten. Sie dürfen nicht als Aussagen über das tatsächliche Backlink-Profil, aktuelle CrUX-Daten oder rechtliche Angaben von Optis Digital interpretiert werden.
Das Bewertungssystem
Ich bewertete überprüfbare Genauigkeit vor Stil. Maximal konnten 100 Punkte erreicht werden: 30 für das Audit, 25 für die Backlink-Analyse, 20 für Metadaten, 20 für JSON-LD und 5 für epistemische Zurückhaltung. Eine sprachlich überzeugende Antwort verlor Punkte, wenn sie den geforderten Nenner veränderte, eine Korrelation als Kausalität darstellte oder eine optionale Verbesserung als Rankinganforderung präsentierte.
Ergebnisse des kontrollierten SEO-Benchmarks
Kategorie
Gewichtung
GPT-5.5 Instant
Claude Sonnet 5 High
Gewinner
SEO-Audit
30
27
22
GPT
Backlink-Analyse
25
24
18
GPT
Titles und Meta-Descriptions
20
17
20
Claude
Organization JSON-LD
20
14
17
Claude
Zurückhaltung und Grenzen
5
5
3
GPT
Gesamt
100
87
80
GPT
Test 1: SEO-Audit
Beide Modelle fanden die zentralen Probleme: keine H1, eine stark auf Blockchain fokussierte Positionierung trotz eines breiteren B2B-Angebots, sieben Bilder ohne brauchbaren Alt-Text, doppelte englischsprachige Navigation, eine deutsche Breadcrumb-Bezeichnung auf der englischen Seite, kein x-default, unvollständige Social-Profile in sameAs, eine Founder-Person ohne @id sowie einen LCP von 3,4 Sekunden innerhalb des kontrollierten Felddaten-Testsets.
Wo GPT besser war
GPT ging disziplinierter damit um, was sich anhand der vorhandenen Daten tatsächlich beweisen ließ. Es bewertete die fehlende H1 als „Hoch“ statt als „Kritisch“, wies darauf hin, dass x-default ein hilfreicher Fallback und keine verpflichtende hreflang-Anforderung ist, und erklärte ausdrücklich, dass der Snapshot die genaue Ursache des LCP-Problems nicht erkennen lässt. Außerdem verzichtete GPT darauf, den bestehenden Title, Canonical, die Indexierbarkeit oder die Meta-Description ohne einen konkreten, datenbasierten Fehler zu beanstanden.
Diese Zurückhaltung ist wichtig. Google erklärt, dass Title-Texte beschreibend und prägnant sein sollten, definiert jedoch in seinen Richtlinien zu Title Links kein universelles Zeichenlimit. Ebenso können Felddaten ein schlechtes LCP-Ergebnis sichtbar machen, eine detaillierte Diagnose erfordert jedoch Telemetriedaten auf Seitenebene; die Web-Vitals-Richtlinien empfehlen dafür Real-User-Monitoring.
Wo Claude Punkte verlor
Claudes Darstellung war übersichtlicher, mehrere Aussagen waren jedoch zu stark formuliert. Claude bezeichnete die H1 als „das stärkste einzelne Onpage-Relevanzsignal“, bewertete ihr Fehlen als „Kritisch“ und behauptete, dies könne Rankings unterdrücken. Die bereitgestellten Daten stützten diese kausalen Aussagen nicht. Außerdem vermutete Claude, dass das LCP-Element „wahrscheinlich“ das Hero-Asset sei, und empfahl dessen Preloading, ohne zuvor einen Trace gesehen zu haben.
Der konkreteste Fehler betraf FAQ-Markup. Claude bezeichnete das fehlende FAQPage-Markup als verpasste Rich-Result-Chance. Für die Website einer kommerziellen SEO-Agentur ist das irreführend: Google erklärt, dass FAQ-Rich-Results auf bekannte, autoritative Regierungs- und Gesundheitswebsites beschränkt sind. Das Hinzufügen von gültigem Markup kann die maschinelle Lesbarkeit weiterhin verbessern, sollte jedoch nicht als wahrscheinliche SERP-Verbesserung verkauft werden. Googles Update zu FAQ-Rich-Results beschreibt diese Einschränkung ausdrücklich.
Audit-Fazit: GPT war der sicherere technische Reviewer für einen ersten Durchlauf. Claude erstellte ein sehr gut lesbares Audit, aber ein erfahrener SEO müsste mehrere Aussagen zu Priorität und Kausalität abschwächen, bevor das Ergebnis an einen Kunden geschickt werden könnte.
Test 2: Analyse des Backlink-Profils
Dies war der objektivste Teil des Experiments. Der bereitgestellte Export enthielt 18 Zeilen, 16 eindeutige verweisende Root-Domains und 10 Root-Domains mit mindestens einem aktiven Follow-Link. Außerdem enthielt er vier Konzentrationssignale: 3.000 Links von einer Domain, 420 von einer weiteren, 50 von einer Domain im Stil eines Link-Marktplatzes und 12 von der Root-Domain einer Publikation. Ein aktiver Follow-Link verwies auf ein 404-Ziel und ein hochwertiger Forschungslink einer Universität war als verloren markiert.
Backlink-Berechnungen und Bewertung
Prüfung
Korrektes Ergebnis
GPT
Claude
Gesamtzahl der Export-Zeilen
18
18
18
Eindeutige verweisende Root-Domains
16
16
16
Aktive Follow-Root-Domains
10
10
9
404-Link-Chance erkannt
Ja
Ja
Ja
Verlorener Forschungslink erkannt
Ja
Ja
Ja
Automatisches Disavow vermieden
Erforderlich
Ja
Ja
GPT berechnete alle drei Werte korrekt. Claude meldete neun aktive Follow-Domains, weil es die geforderte Kennzahl stillschweigend in „aktive Follow-Root-Domains mit Target-Status 200“ änderte und die Domain ausschloss, deren Ziel-URL einen 404-Status zurückgab. Das kann eine nützliche zusätzliche Kennzahl sein, entspricht aber nicht der gestellten Frage.
Beide Modelle verzichteten richtigerweise auf ein automatisches Disavow. GPT formulierte vorsichtiger: Ungewöhnliche Domainnamen, kommerzielle Anchors, geringer geschätzter Traffic und eine hohe Anzahl von Links wurden als Gründe für eine genauere Prüfung beschrieben und nicht als Beweis für Manipulation. Claude verwendete Formulierungen wie „klassische Linkfarm-Signatur“ und „typisches Muster eines Marktplatzes für bezahlte Links“. Diese Aussagen klangen überzeugend, gingen aber über die geschlossene Datenbasis hinaus. Google selbst beschreibt das Disavow-Tool als fortgeschrittene Maßnahme für Situationen mit unnatürlichen Links und nicht als Bereinigungswerkzeug für jeden unattraktiven Backlink.
Claude verwendete außerdem eine seiner fünf Backlink-Maßnahmen darauf, X zu sameAs der Organization hinzuzufügen. Dieser Vorschlag gehörte in den Bereich Structured Data und verdrängte dadurch eine relevantere Linkbuilding-Maßnahme.
Backlink-Fazit: GPT gewann bei Berechnungen, Einhaltung des Aufgabenrahmens und Risikosprache. Claude erkannte die wichtigsten Chancen, aber der veränderte Nenner und die stärker formulierten Bewertungen machen eine menschliche Prüfung unverzichtbar.
Test 3: Titles und Meta-Descriptions
Claude gewann diese Runde eindeutig. Jeder Title enthielt das exakte Keyword, alle Titles lagen unter 60 Zeichen, alle Beschreibungen zwischen 145 und 160 Zeichen und jede angegebene Zeichenzahl stimmte mit einer unabhängigen Unicode-Zeichenzählung überein.
Unabhängige Überprüfung der Zeichenzahlen
Modell
Ausgabe
Angegeben
Tatsächlich
Bestanden
GPT
Title 1 / Description 1
46 / 158
46 / 157
Ja
GPT
Title 2 / Description 2
53 / 156
53 / 155
Ja
GPT
Title 3 / Description 3
48 / 147
48 / 145
Ja
Claude
Title 1 / Description 1
50 / 148
50 / 148
Ja
Claude
Title 2 / Description 2
44 / 159
44 / 159
Ja
Claude
Title 3 / Description 3
47 / 154
47 / 154
Ja
GPTs Texte waren veröffentlichungsfähig, doch bei den drei Beschreibungen lagen die angegebenen Zeichenzahlen um ein, ein beziehungsweise zwei Zeichen daneben. Claudes empfohlenes Paar verwendete außerdem die Formulierung „eine Website“, eine sinnvolle Einschränkung, die verhindert, dass ein einzelnes Experiment als universell gültig dargestellt wird.
In diesem Test wurden Zeichenbereiche als Produktionsvorgabe verwendet und nicht als Google-Regel. Google erklärt, dass es keine feste maximale Länge für Meta-Descriptions gibt und Snippets je nach Gerät gekürzt werden. Genauigkeit, Einzigartigkeit und Nutzen sind wichtiger als die Jagd nach einer vermeintlich perfekten Zeichenzahl; siehe Googles Richtlinien zu Meta-Descriptions.
Metadaten-Fazit: Claude war besser für SEO-Texte mit klar definierten Einschränkungen. Bei einer Produktion in großem Maßstab würde ich jedoch nach beiden Modellen weiterhin eine deterministische Längenprüfung einsetzen, statt den vom Modell selbst angegebenen Zeichenzahlen zu vertrauen.
Test 4: Organization JSON-LD
Beide Modelle verstanden die zentrale Anforderung an den Entity-Graph: die bestehende @id der Organization wiederverwenden, eine stabile, zur Website gehörende @id für die Person erstellen und beide Nodes über Referenzen miteinander verbinden. Beide verzichteten auf Bewertungen, Auszeichnungen, Straßenadressen und Telefonnummern, die nicht im Prompt enthalten waren.
GPT machte den schwerwiegenderen Modellierungsfehler. Es ordnete Bayreuth als Adresse der Organization zu, obwohl das Testdatenset ausdrücklich angab, dass München das operative Büro und Bayreuth der Ort für rechtliche/steuerliche Zwecke sowie die für die Website verantwortliche Person war. Zusätzlich erstellte GPT einen Munich Place, wodurch zwei unterschiedliche Standortkonzepte mit der Organisation verknüpft wurden, was bei der Implementierung zu Verwirrung führen könnte.
Claude ordnete die eingeschränkte Bayreuth-Adresse der Person zu und ließ die Organization mit dem Gründer verknüpft. Das entsprach der bereitgestellten geschäftlichen Semantik besser. Allerdings führte Claude zusätzlich einen neuen WebSite-Node ein und räumte ein, dass dessen erfundene @id ersetzt werden müsse, falls die Live-Seite bereits einen anderen Identifier verwendet. Die sicherere Lösung wäre gewesen, diesen unnötigen Node wegzulassen, bis der bestehende Graph geprüft wurde.
Verwenden Sie bestehende Identifier erneut, veröffentlichen Sie ausschließlich verifizierte Fakten aus der realen Welt und validieren Sie den zusammengeführten Graphen – nicht nur das neu hinzugefügte Fragment. Googles Dokumentation zu Organization Structured Data empfiehlt, Eigenschaften hinzuzufügen, die tatsächlich auf die Organisation zutreffen; mehr Markup ist nicht automatisch besser.
Schema-Fazit: Claude gewann knapp, weil es das Detail zur juristischen beziehungsweise verantwortlichen Person genauer modellierte. Keines der beiden Ergebnisse sollte jedoch direkt in die Produktion übernommen werden, ohne es mit dem vollständigen Live-Graphen abzugleichen.
Welche KI sollte ein SEO im September 2026 verwenden?
Praktische Modellauswahl nach SEO-Aufgabe
SEO-Aufgabe
Besserer Ausgangspunkt in diesem Test
Warum
Verpflichtende menschliche/Tool-Prüfung
Technisches Audit-Triage
GPT
Bessere Priorisierung und weniger unbelegte Ursachen
Besserer Umgang mit Fakten zu Person versus Organization
Zusammenführung mit Live-Graph, Validator, rechtliche/geschäftliche Verifizierung
Kundenreife Aufbereitung
Claude
Übersichtlichere Formatierung und natürlich wirkende, ausgearbeitete Erklärungen
Übertriebene Aussagen entfernen und jeden Fakt prüfen
Gemischter Workflow mit nur einem Modell
GPT
Genauigkeit und Zurückhaltung wogen schwerer als die Fehler bei der Zeichenzählung
Aufgabenspezifische QA-Prüfungen
Wenn ich auf Grundlage dieses kontrollierten Vergleichs nur einen Assistenten für einen gemischten technischen SEO-Arbeitstag auswählen müsste, würde ich GPT wählen. Der Vorsprung entstand nicht durch schönere Texte, sondern dadurch, dass GPT die geforderte Kennzahl beibehielt, Belege von Schlussfolgerungen trennte und erkannte, wann der Datensatz nicht ausreichte, um eine Ursache zu diagnostizieren.
Claude würde ich für die Erstellung großer Mengen an Metadaten-Ideen, Briefings, Überarbeitungen und kundengerichteten Texten wählen und anschließend deterministische Prüfungen für Längen und Fakten einsetzen. Auch die aktuellen API-Kosten verdienen Beachtung: Anthropic listet Sonnet 5 mit 2 US-Dollar pro Million Input-Tokens und 10 US-Dollar pro Million Output-Tokens, Opus 5 mit 5/25 US-Dollar und Fable 5.1 mit 10/50 US-Dollar. Preise können sich ändern, daher sollten sie vor dem Aufbau einer Produktionspipeline auf Anthropics offizieller Preisseite überprüft werden.
Der bessere Workflow lautet nicht „einen Gewinner wählen und alles automatisieren“
Das zuverlässigste SEO-System trennt Datenerfassung, Analyse und Produktion:
Daten mit spezialisierten Tools sammeln. Verwenden Sie je nach Bedarf einen Crawler, Search Console, Analytics, einen Backlink-Index, PageSpeed/CrUX und Server-Logs.
Dem Modell ein geschlossenes Datenpaket geben. Definieren Sie Aufgabe, Nenner, erlaubte Annahmen, Ausgabeformat und Abbruchbedingungen.
Deterministische Validatoren verwenden. Berechnen Sie Werte erneut, parsen Sie JSON, validieren Sie Structured Data, prüfen Sie Statuscodes und erzwingen Sie Title-/Description-Grenzen im Code.
Kennzeichnung von Unsicherheit verlangen. Das Modell sollte Beobachtungen, Schlussfolgerungen, Empfehlungen und fehlende Belege getrennt kennzeichnen.
Eine menschliche Freigabe beibehalten. Das ist besonders wichtig bei Redirects, Canonicalization, hreflang, Schema-Fakten, Outreach zur Linkentfernung und Disavow-Dateien.
Dieser Ansatz entspricht außerdem Anthropics sinnvoller Empfehlung, Evaluierungen rund um den eigenen realen Anwendungsfall aufzubauen, anstatt ein Modell ausschließlich anhand allgemeiner Benchmarks auszuwählen. Das beste SEO-Modell ist dasjenige, das Ihre eigenen reproduzierbaren Tests zu akzeptablen Kosten besteht.
Einschränkungen dieses Vergleichs
Es handelt sich um einen kontrollierten Prompt und jeweils eine Ausgabe pro Modellkonfiguration, nicht um eine statistisch signifikante Stichprobe.
Der Test verglich GPT-5.5 Instant mit Claude Sonnet 5 High über Arena und nicht die aktuell leistungsfähigsten Flaggschiffmodelle von OpenAI und Anthropic.
Die Modelle nutzten weder Browsing noch Crawling, SEO-APIs oder produktspezifische Agent-Tools. Ergebnisse in Consumer-Anwendungen können sich aufgrund von System-Prompts, Connectors, Memory und Tool-Orchestrierung unterscheiden.
Der Benchmark bewertete analytische Korrektheit und die Einhaltung von Anweisungen, nicht Rankinggewinne, Traffic, Conversions, Antwortlatenz oder gesamte Token-Kosten.
Modell-Aliase und gehostete Konfigurationen können sich ändern. Dokumentieren Sie bei jeder Evaluierung die genaue Modell-ID, das Datum, den Prompt und die verwendeten Einstellungen.
Fazit
Für den getesteten SEO-Workflow im September 2026 ist GPT die bessere Allround-Option; Claude ist der bessere Spezialist für Metadaten und ausgearbeitete redaktionelle Inhalte. GPTs Sieg mit 87 zu 80 Punkten beruhte auf technischer Zurückhaltung und genauerer Backlink-Analyse und bedeutet keine universelle Überlegenheit in jedem SEO-Anwendungsfall. Claudes perfekte Zeichenzählung bei Metadaten und die sauberere Entity-Modellierung zeigen, warum ein aufgabenspezifischer oder Multi-Modell-Workflow besser funktionieren kann als die Bindung an eine einzelne Marke.
Die wichtigste langfristige Erkenntnis geht über beide Punktzahlen hinaus: KI ist nützlich, wenn sie ein klar definiertes Datenpaket analysiert, und gefährlich, wenn flüssige Sprache mit gemessener Wahrheit verwechselt wird. Lassen Sie Crawler und First-Party-Plattformen die Fakten sammeln; lassen Sie Modelle diese strukturieren und interpretieren; und lassen Sie einen erfahrenen SEO die Maßnahmen freigeben.
Häufig gestellte Fragen
„`
Ist ChatGPT besser als Claude für SEO?
Für den hier getesteten gemischten technischen Workflow war die GPT-Konfiguration insgesamt besser. Claude war bei streng vorgegebenen Metadaten besser und beim JSON-LD-Test leicht überlegen. Das Ergebnis kann sich je nach Modell, Prompt, verwendeten Tools und Qualität der bereitgestellten Daten ändern.
Kann eine der beiden KIs ein vollständiges SEO-Audit durchführen?
Nein. Eine KI kann einen Crawl-Export oder einen strukturierten Snapshot interpretieren, aber ein vollständiges Audit erfordert Live-Crawling, Rendering, Belege zur Indexierung, Suchperformance-Daten, Felddaten zur Performance und häufig auch Server-Logs. Ohne diese Inputs prüft das Modell ein Briefing – nicht die gesamte Website.
Sollte eine KI entscheiden, welche Backlinks disavowed werden?
Nein. Sie kann Links clustern und für die Prüfung priorisieren, aber eine Disavow-Entscheidung erfordert Informationen zur Akquisitionshistorie, den Kontext möglicher manueller Maßnahmen und menschliches Urteilsvermögen. Ein verdächtiger Domainname, geringer geschätzter Traffic oder eine hohe Anzahl von Links reicht allein nicht aus.
Welche aktuellen Modelle sollte ein SEO-Team evaluieren?
Stand September 2026 gehören GPT-6 Astra und GPT-5.6 Sol von OpenAI sowie Claude Fable 5.1, Opus 5 und Sonnet 5 von Anthropic zu den aktuellen leistungsfähigen Optionen. Beginnen Sie mit der Modellstufe, die zu Ihrem Budget passt, und führen Sie anschließend dieselbe aufgabenspezifische SEO-Evaluierung mit allen Kandidaten durch.
With years of experience navigating the ever-evolving crypto landscape, Eugen knows exactly how to make content shine in Google’s eyes—without breaking the algorithm. With experience working as an SEO specialist in real fast-growing crypto companies, along with training in crypto trading, Google Ads Search Certification, and Google Analytics Individual Qualification, he is a master of SEO in the crypto world, blending AI-powered strategies with deep industry knowledge. From ChatGPT to blockchain trends, he knows how to make content rank, engage, and convert.